ソフトウェア品質保証ガイド執筆記

 以前のブログ記事(「「ソフトウェア品質保証ガイド」を執筆しました - 千里霧中」)でも触れましたが、書籍「ソフトウェア品質保証ガイド」が今週末に発売されます。今回はその執筆の顛末をまとめたいと思います。

執筆の経緯

 去年の春ごろ前著「ソフトウェアテスト徹底指南書」の原稿を出版社に入稿したのですが、その執筆が終わっても燃え尽きることなく、執筆に注いでいたエネルギーが浮いている状態でした。さらに徹底指南書向けに書いていたもののテストと関係がないということでカットした文章が溜まっており、何かしらでそれを活用したいと考えていました。
 そうした背景から、新しい本を書きたいとSNSにつぶやいていたところ、Mark Wardさんに拾っていただき、出版社であるアスキードワンゴ様(現・ZEN大学出版会様)へとつないでいただきました。そして提案書をやり取りしたのち、正式に本書執筆をスタートしました。

執筆活動の中断とリカバリ

 ただ本書執筆はスムーズには進みませんでした。というのも前著「ソフトウェアテスト徹底指南書」発売から登壇依頼が急増し、毎月以上のペースで講演やセミナー講師の予定が入る状態になりました。平日は仕事をこなしながらであったため、執筆時間の確保ができなくなり、半年ほど執筆が停滞する形になりました。執筆を本格化できたのは去年の8月頃からで、半年程度でなんとか書き上げる形になりました。

さまざまな方のご助力

 本書の執筆にあたっても、多くの方々にレビューのご支援をいただきました。
 妻や鈴木一裕さんには、全体を通した詳細なレビューを行っていただきました。Mark Wardさんには、本書を執筆する機会を設けていただいただけでなく、レビューにもご協力いただきました。また、安達賢二さん、伊藤由貴さん、大段智広さん、河野哲也さん、末村拓也さん、細谷泰夫さん、森崎修司さんに、さまざまな分野についての高度な知見・知識をご教示いただきました。
 このレビューを通して、非常に深い学びを得ることができました。ご協力いただいた皆様、改めて大変ありがとうございました。

お願い

 本書の評価は読者にお委ねしたいと考えています。ただ心配な点として、ソフトウェアの品質管理・品質保証をテーマにした書籍は、ジャンルとして売れない実情があるとのことです。名著と呼ばれる本でも採算面で非常に厳しい状況だと出版社の方から伺っています(そうしたジャンルとしての傾向があり、本書の価格は高めに設定されています)。そのため内容を良いと感じていただいた方がいたら、ぜひ購入いただけると幸いです。

アーキテクトやアーキテクティングは生成AI活用で不可欠。AI活用のこれから

 最近、生成AIによってアーキテクトやテックリードが不要になるのではないかという議論を見かけました。

 こうした話の妥当性は開発のコンテキストによって変わるので一概に肯定・否定できる話ではないと思います。
 ただ自分個人としては、生成AIの活用拡大で、プロダクトのアーキテクチャやアーキテクトの重要性は高まり、ソフトウェア開発はアーキテクティング(アーキテクチャの構築・維持活動)の比重が増していくと考えています。今回はそれについて意見をまとめます。

生成AI活用ではアーキテクチャの工夫が不可欠

 プロダクトのアーキテクチャはソフトウェアエンジニアリング推進や技術活用の点でも重要です。
 生成AIの活用においても、そのリスクコントロールや、有効性・正確性向上の点で、アーキテクチャが大きく貢献します。具体的には、次のような形で、プロダクトのアーキテクチャやアーキテクティングが生成AI活用を支えます。

分割統治による問題のシンプル化

 生成AIは、複雑で多岐にわたる問題を一括で解かせようとすると誤答率が上がります。逆に、問題を扱いやすい単位へと分解し、ステップバイステップで処理させると有効性や精度が高まります。さらにその成果物の品質保証も容易になります。
 そのため、アーキテクティングによる分割統治で、ソフトウェア開発上の問題を小さな問題に分解するのが、生成AIの活用拡大に有効です。

疎結合・高凝集設計の推進による問題のコンテキストとスコープの明確化

 生成AIは、指定される問題のコンテキストやスコープが明確であるほど、生成成果物の品質が向上します。
 そのため、アーキテクティングで関心の分離、高凝集設計、疎結合設計を推進すると、個々のコンポーネントの責務のコンテキストやスコープがシンプルかつ明確になり、生成AIの有効性向上に貢献します。

プロダクトリスクの分離の推進

 現状の生成AIの生成成果物は、ハルシネーションによる誤生成や、細かなコンテキスト・制約への対応未達が度々発生します。また、サプライチェーンアタックの脆弱性といったプロダクトリスクの原因混入もあり得ます。
 こうした許容できないプロダクトリスクが伴う技術を活用する場合、プロダクトリスクの分離をアーキテクチャで実現する必要があります。具体的には、疎結合設計を推進し、特定の問題(例えば生成AIが脆弱性あるコードを生成してしまうなど)が発生しても、特定のコンポーネントやサービスに問題の被害を局所化するアーキテクティングが求められます。例えばウェブサービスならばバルクヘッドパターンといったアーキテクチャの採用が求められます。

重大なプロダクトリスクに対する設計・実装によるコントロール

 現状の生成AIは前述のハルシネーションや、サプライチェーンアタックなどのリスク混入の問題を持ちます。また開発の機密情報の外部漏洩や、開発環境の破壊、OSSのライセンス混入といった問題も残っています。こうした問題はサービス側で日々改善されていますが、完全解決はまだ先だと思います。
 アーキテクティングでは、そうした重大なリスクを識別し、設計・実装としてコントロールしていく活動を行います。例えばサプライチェーンアタックのリスクが重大ならば、開発プラットフォームを開発コンテナ内に閉じ込められるように、技術スタックを選択したりアーキテクチャを組んだりする対策を方針立てします。生成AIの活用を支えるための設計の工夫や方針立てに、アーキテクチャ設計が有効であるということです。

現状の生成AIでも対応が難しいアーキテクティングの活動

 また、アーキテクトの仕事の中には、現状の生成AIでは丸投げしにくい活動があるというのも留意が必要です。
 そもそもアーキテクティングは、単純作業ではありません。多様なステークホルダーとのすり合わせを通して、あるべきプロダクトを実現するための見通しを立てる作業です。例えばアーキテクティングでは、次のような要求・制約を折衝して、プロダクトによるソリューションを導き出す必要があります。

  • ユーザーからの要求:例えば顧客満足を実現するための体験や品質の実現
  • ビジネスからの要求・制約:例えば投資対効果(ROI)の確保、事業の維持・成長、予算やスケジュールの制約対応
  • 開発からの要求・制約:例えばチームの技術力・リソース、開発スケジュールへの対応
  • 運用からの要求・制約:例えば運用のしやすさ、障害対応の容易さ、シフトライトテスト実現といった品質要求の実現

 例えば、どれほどユーザーから強く求められている機能であっても、ビジネス上の採算を度外視した過剰品質は非現実的です。また、いくら魅力的なアイデアであっても、開発・運用が困難なプロダクトは実現できません。それらの折衝・解決が、アーキテクティングに求められます。

 こうしたソリューションの確立では、その現場に合わせたアーキテクトの知力・経験の発揮が求められます。生成AIでサポートできる部分もありますが、丸投げは無理です。例えば次のような活動は、アーキテクトの属人的な能力発揮が必要です。

  • 公的機関や監査機関と連携して法規・行政手続きのハードルをクリアしたり、事業パートナーと直接交渉・調整を行ったりして、ビジネスモデルの現実的な目処を立てる
  • プロトタイピングやユーザーテスト、開発・運用のフィードバックループの推進などからのフィードバックを活用し、言語化・数値化が難しい主観的・曖昧なプロダクト品質も高め、顧客満足を向上させる

生成AI活用でむしろ重要性が増すアーキテクティングとアーキテクト

 前述の通り、生成AI活用を広げるためのアーキテクティング、生成AIに任せられないアーキテクティングの活動が多く存在します。そのためソフトウェア開発を生成AIに任せるほど、アーキテクティングの活動比率が高まりますし、それをこなすアーキテクトの重要性が高まっていくと思います。将来的には生成AIに任せられるアーキテクティングも増えていくと思いますが、そうした傾向下でも、生成AIのリスクコントロールや、ビジネス・ユーザにより近づいた活動にシフトする形で、アーキテクトが残ると思います。

 生成AIによって、ソフトウェアエンジニアが扱えるものがどんどんスケールアップしています。それにより、よりビジネスやユーザに近づいたアーキテクティング、より大規模で抽象度の高いアーキテクティングの活動比率がどんどん高まっていくのが、現在の流れだと考えています。

宣伝

 今月末に「ソフトウェア品質保証ガイド チームで顧客満足を実現するためのアプローチ・手法・技術」という本を出版します。

「ソフトウェア品質保証ガイド」を執筆しました - 千里霧中

 この本は顧客満足の実現をメインテーマとした本です。そして顧客満足実現の要として、アーキテクチャやアーキテクティングの工夫の解説も行っていて、本文章の内容も扱っています。この文章に興味を持っていただいた方がいたら、購入いただけますと大変嬉しいです。

「ソフトウェア品質保証ガイド」を執筆しました

 今月の8月28日に、執筆した「ソフトウェア品質保証ガイド チームで顧客満足を実現するためのアプローチ・手法・技術」が発売されます。

https://www.kadokawa.co.jp/product/302607002896/

 この本は、顧客満足を実現する活動を品質保証とし、ソフトウェアプロダクトの開発から運用までライフサイクル全体に求められる品質保証活動について解説しています。
 読者はQAエンジニアに限定せず、開発チームに関わるエンジニアやマネージャ全般に広く読んでいただくことを想定して執筆しました。
 トピックとして次のような内容を扱っています。

  • シフトレフトや品質の積み上げの実践
  • 開発と運用のフィードバックループの推進による顧客満足の向上
  • 要求分析から設計、実装、テストまで、ソフトウェア開発ライフサイクル上で有効な顧客満足の実現・向上活動
  • 生成AI活用や開発プラットフォーム整備といった技術活用
  • 顧客満足を支えるアーキテクティング
  • 顧客満足を維持・向上するための保守性・運用性作りこみ

 ぜひ買っていただけると嬉しいです。
 内容の参考として、目次を列挙します。

第1章 品質と品質保証
 1.1 本書における品質保証の定義 
 1.2 品質とは 
  1.2.1 品質の難しさ
  1.2.2 自分たちにとっての品質を追求しなければならない
  1.2.3 あるべき品質を追求する
  1.2.4 品質のさまざまな側面や種類
  1.2.5 品質モデル
  1.2.6 現代的なソフトウェア開発を支える品質
  1.2.7 品質を支える開発組織
 1.3 ソフトウェアの品質保証とは
  1.3.1 品質保証の定義
  1.3.2 顧客満足を実現するための活動
  1.3.3 開発チームの力を伸ばす品質保証の基本方針
  1.3.4 三現主義・五ゲン主義で品質保証活動を推進する
  1.3.5 ソフトウェア品質保証の当事者
  1.3.6 品質保証で避けるべき姿勢
  1.3.7 品質マネジメントシステムを整備する
  1.3.8 ハードウェア開発とソフトウェア開発での品質保証の違い
 1.4 QA エンジニアの価値 
  1.4.1 QA エンジニアとしての価値の確立 
  1.4.2 QA エンジニアのロールモデル 

第2章 品質保証のアプローチ
 2.1 品質のシフトレフト
  2.1.1 シフトレフトの恩恵
  2.1.2 シフトレフトの誤解
  2.1.3 シフトレフトを支える施策
  2.1.4 W モデル
 2.2 品質改善サイクルの推進
  2.2.1 PDCA サイクル 
  2.2.2 品質改善サイクルの種類
  2.2.3 源流管理と水平展開
  2.2.4 品質改善サイクルの組織定着
  2.2.5 改善サイクルをまわすためのバグ情報の蓄積
  2.2.6 ODC 分析
 2.3 プロダクトリスクの分離
  2.3.1 プロダクトリスクの分離を支える施策
  2.3.2 バルクヘッドパターン
  2.3.3 汚染防御設計
  2.3.4 ソフトウェア安全クラスの分離
 2.4 品質の積み上げ
  2.4.1 工程品質の積み上げ
  2.4.2 スパイラル型品質の積み上げ
  2.4.3 コンポーネント品質の積み上げ
 2.5 体系的品質保証
  2.5.1 品質保証の体系化のアプローチ
  2.5.2 テスト活動の体系化
  2.5.3 体系的品質保証で留意すべき効果や法則

第3章 開発アプローチに合わせた品質保証
 3.1 アジャイル開発での品質保証アプローチ
  3.1.1 アジャイルソフトウェア開発宣言
  3.1.2 アジャイルの原則
  3.1.3 アジャイルテストの原則
  3.1.4 アジャイルテストの四象限
  3.1.5 アジャイルを支える品質保証体制
  3.1.6 アジャイルでの品質保証のアプローチ
  3.1.7 スクラムを支える品質保証
  3.1.8 スクラムを支える品質保証体制
  3.1.9 プロジェクトのコンテキストにアジャイルを適応させる
 3.2 DevOps での品質保証アプローチ 
  3.2.1 DevOps とは 
  3.2.2 ホリスティックテスト
  3.2.3 DORA Four Keys と品質保証での対応 
  3.2.4 DevOps を支える品質保証体制
  3.2.5 DevOps を支える品質保証のアプローチ

第4章 品質の評価
 4.1 品質の評価
  4.1.1 仕組みの評価で品質を保証する
  4.1.2 品質メトリクスの選択
  4.1.3 GQM 
  4.1.4 評価基準の設定
  4.1.5 品質評価を支える計画と仕組みづくり
  4.1.6 品質保証としての品質評価の心がけ
  4.1.7 品質評価の手段
 4.2 レビュー
  4.2.1 レビューの強みと弱み
  4.2.2 レビューの適用領域
  4.2.3 レビューを行うポイント
  4.2.4 レビューの効果を引き出すための工夫
  4.2.5 レビューが適切に実施されているかの確認
  4.2.6 レビューの手法・技法
 4.3 静的解析
  4.3.1 静的解析の強みと弱み
  4.3.2 静的解析の適用領域
  4.3.3 静的解析を行うポイント
  4.3.4 静的解析の効果を引き出すための工夫
  4.3.5 静的解析の技術
  4.3.6 生成 AI による静的解析
 4.4 動的テスト
  4.4.1 動的テストの適用領域
  4.4.2 動的テストを行うポイント
  4.4.3 動的テストの効果を引き出すための工夫
  4.4.4 動的テストの分類や種類
  4.4.5 探索的テスト
 4.5 モニタリング
  4.5.1 プロダクトのモニタリング
  4.5.2 プロセス品質のモニタリング
  4.5.3 品質保証で活用できるプロセス品質のメトリクス
  4.5.4 モニタリングを支える品質の見える化
  4.5.5 モニタリングの効果を引き出す工夫

第5章 開発工程を支える
 5.1 開発工程を支える
  5.1.1 開発ライフサイクル上の品質の要所を押さえる
  5.1.2 少数の品質保証リソースで開発を支えるための工夫
  5.1.3 開発スピードを損なわず開発を支えるための工夫
 5.2 要求分析・要件定義を支える
  5.2.1 要求分析・要件定義の適正化を支援する
  5.2.2 品質要求を分析し要件化する
  5.2.3 ユーザや現場を観察して品質保証の知見を学ぶ
 5.3 設計・実装を支える
  5.3.1 顧客満足を支える品質の実現をサポートする
  5.3.2 品質と開発のスピード・レジリエンス・持続性の共立を支える
  5.3.3 適切な保守性の確保
  5.3.4 適切なテスト容易性の確保
  5.3.5 運用を支える品質の確保
  5.3.6 設計・実装の品質の維持
 5.4 アーキテクチャ設計を支える
  5.4.1 品質に関わるアーキテクチャ設計判断をサポートする
  5.4.2 関心の分離、SLAP で責務を調整する 
  5.4.3 プロダクトリスクの分離、コンポーネント品質の積み上げを支える
  5.4.4 アーキテクチャの疎結合設計の具体例:依存性逆転の原則
  5.4.5 副作用の局所化で疎結合設計を推進する
  5.4.6 契約による設計で凝集性を確保する
  5.4.7 アーキテクチャ品質の評価
  5.4.8 アーキテクチャ品質は顧客満足実現とビジネス成功の要
  5.4.9 アンチパターン:アジャイルではアーキテクチャ品質も差分開発で構築する
 5.5 開発者テストを支える
  5.5.1 開発者テストとは
  5.5.2 テスト駆動開発
  5.5.3 開発者テストを支える要点
  5.5.4 開発者テストを書く習慣をチームに定着させる
  5.5.5 開発者テストの網羅性の確保
  5.5.6 開発者テストの有効性の確保
  5.5.7 開発者テストの保守性の確保
  5.5.8 開発者テストをチームの資産として運用する
  5.5.9 開発者テストにおける生成 AI の活用
 5.6 テストを支える
  5.6.1 テストの作成のサポート
  5.6.2 テストの評価のサポート
  5.6.3 テスト実行のサポート
  5.6.4 テストの品質の確保
  5.6.5 テストの保守性の確保
  5.6.6 テストの信頼性の確保
  5.6.7 テストコードの品質確保
 5.7 リリースを支える
  5.7.1 コンテキストに合わせたリリース方針の選択

第6章 開発活動を支える
 6.1 変更を支える
  6.1.1 変更に対する事前の備え
  6.1.2 変更に対する品質保証の流れ
  6.1.3 変更レビューを支えるバージョン管理システムと CI/CD
  6.1.4 リスクベースドテストでピンポイントにリスクを確認する
 6.2 ユーザビリティ確保を支える
  6.2.1 ユーザビリティとは
  6.2.2 ユーザビリティの品質保証の流れ
  6.2.3 数字や言葉で扱えないユーザビリティを扱う
  6.2.4 A/B テスト
  6.2.5 ヒューリスティック評価 / エキスパートレビュー 
 6.3 性能効率の確保を支える
  6.3.1 性能効率性とは
  6.3.2 性能効率性の要求分析
  6.3.3 性能効率性確保のポイント
  6.3.4 性能確保の品質保証の基本方針
  6.3.5 性能テストの要点
 6.4 生成 AI の活用を支える
  6.4.1 ソフトウェア開発での生成 AI の活用
  6.4.2 生成 AI の課題に対応するためのポイント
  6.4.3 生成 AI により開発のボトルネックになる品質保証

第7章 運用・保守を支える
 7.1 運用・保守を支える
  7.1.1 現代的なソフトウェア開発における運用・保守
  7.1.2 プロダクトのデプロイプロセスの整備
  7.1.3 顧客満足の評価と改善
  7.1.4 運用と開発の連携による継続的改善
  7.1.5 ソフトウェアの適切な廃止
  7.1.6 品質悪化への対応 
  7.1.7 フィールドエンジニアリングで品質保証の力を磨く
 7.2 運用中のモニタリングと評価
  7.2.1 モニタリング指標の選択
  7.2.2 モニタリングの仕組みの構築
  7.2.3 プロアクティブアプローチの推奨
  7.2.4 シフトライトテスト
 7.3 市場の品質問題管理
  7.3.1 市場の品質問題の詳細
  7.3.2 市場の品質問題に対応する姿勢
  7.3.3 市場の品質問題への備え
  7.3.4 品質問題情報の蓄積
  7.3.5 市場の品質問題対応プロセスの整備

第8章 マネジメントを支える
 8.1 開発計画を支える
  8.1.1 品質計画の策定
  8.1.2 顧客満足に向けた開発計画の改善
  8.1.3 開発計画の評価と洗練
  8.1.4 見積もりとコミットメントを分ける
  8.1.5 計画の保守・運用
  8.1.6 品質戦略の策定
  8.1.7 アジャイル開発での計画のサポート
 8.2 マネジメントのモニタリングとコントロール
  8.2.1 品質保証としてプロダクトマインドセットを維持する
  8.2.2 品質の積み上げで進捗と品質を連動させる
  8.2.3 事前のモニタリング設計に注力する
  8.2.4 品質保証としてのマネジメントモニタリング
  8.2.5 モニタリングに基づいたコントロール
 8.3 リスクマネジメント
  8.3.1 リスクとリスクマネジメント
  8.3.2 リスクマネジメントの活動
  8.3.3 品質保証としてのリスクマネジメント
  8.3.4 品質リスクのマネジメントの要点

第9章 品質保証を支える仕組みの構築
 9.1 顧客満足を継続的に支える仕組みの構築
  9.1.1 有効な仕組み作りの工夫
  9.1.2 ISO 9000 の品質マネジメントの原則 
  9.1.3 仕組みとしての開発インフラの整備
  9.1.4 CI/CD 
  9.1.5 バージョン管理システム
  9.1.6 ビルドシステム
 9.2 開発プロセスの構築
  9.2.1 開発プロセスの構成
  9.2.2 開発プロセスモデルと開発方法論
  9.2.3 プロセスアプローチ
  9.2.4 品質保証を支える開発プロセスの構築方針
  9.2.5 開発プロセスを構成する各工程の構築方針
  9.2.6 品質保証を支援するプロセスを整備する
  9.2.7 生きたプロセスを維持する
  9.2.8 開発プロセス構築の流れ
 9.3 開発プロセスの改善
  9.3.1 開発プロセス改善の要点
  9.3.2 開発プロセス改善の流れ
 9.4 品質保証体制の構築
  9.4.1 組織構成と役割・責任の設計
  9.4.2 組織としての品質保証能力の維持
  9.4.3 品質保証を支える教育 
 9.5 品質保証を支える品質文化の形成
  9.5.1 あるべき姿を立脚点にする
  9.5.2 品質文化の形成
  9.5.3 品質文化の可視化
  9.5.4 品質についての適切なコミュニケーションの活性化
  9.5.5 チーム全体アプローチの実現
 9.6 品質保証の人材確保
  9.6.1 品質保証人材に求められる能力
  9.6.2 品質保証にかかわる人材の採用
  9.6.3 人材採用の流れ

第10章 品質保証に関わる手法・技術・アプローチ
 10.1 レビューの方法・技法 
  10.1.1 レビュー運営種別 
  10.1.2 レビューのリーディング技法 
  10.1.3 チームレビューの進め方 
  10.1.4 プルリクエスト/マージリクエストレビューの進め方
  10.1.5 パースペクティブベースドレビューの進め方 
  10.1.6 モビング(チーミング)の進め方
 10.2 システムテストのテスト設計アプローチ 
  10.2.1 システムテストでのテスト設計プロセスの工夫 
  10.2.2 テスト分析 
  10.2.3 テスト設計 
  10.2.4 テスト実装 
 10.3 モデリング 
  10.3.1 モデリングは要点を表現する 
  10.3.2 モデルの記法 
  10.3.3 モデリングは探索的 
  10.3.4 品質保証を支えるモデリング 
  10.3.5 状態遷移モデルによる状態分析 
  10.3.6 Why ツリーによる原因分析

G-Evalを使用してLLM-as-a-judgeを行う

 生成AIを組み込んだソフトウェアの評価では、出力の不確実性や柔軟性が大きいことから、対象をどう評価するかが定番の課題となります。その有望な対応手段にLLM-as-a-judgeがあります。
 LLM-as-a-judgeは、生成AIの出力結果の評価・採点を、精度の高いLLMを使って実施する手法です。LLMの柔軟性を活用して、多数かつ幅広い評価の自動化が行えるようになります。

 今回はそのLLM-as-a-judgeの実装例を解説します。評価の実装および実行環境は「生成AIアプリケーション評価入門」の解説を参考にしています。

LLM-as-a-judgeの評価者に使用するLLM

 評価にはLLM-as-a-judgeのフレームワークであるG-Evalを使用します。
 またG-Evalが利用するLLMとして、OpenAIのGPTを使用します(そのため以降のコード実行においては、本ブログ執筆時点ではOpen AIに課金し、API Keyを有効にする必要があります。有効化したKeyは実行環境の環境変数OPENAI_API_KEYに登録しておきます)。

評価対象のLLM

 評価対象は、ローカルで実行できるLLM、ollamaを使用します。テスト自動生成でのテスト観点の生成を想定して、「プロダクト品質モデルの主特性の名前を列挙してください」のような課題を指定し、その正確性を評価します。

LLM-as-a-judgeの実装

 LLM-as-a-judgeの実装を以下に示します。

from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCase, SingleTurnParams
from openai import OpenAI
import ollama

# テスト対象
input="ISO/IEC 25010におけるプロダクト品質モデルの主特性の名前を列挙してください"
response = ollama.chat(model='llama2', messages=[{'role': 'user', 'content': input,}], options={'temperature': 0})

# 評価内容(生成AIアプリケーション評価入門より)
correctness_metric_ja = GEval(
	name="正確性",
	evaluation_steps=[
	"実際の出力に含まれる事実が、期待される出力に含まれる事実と矛盾していないかを確認してください。",
	"重要な情報が省略されている場合は大きく減点してください。",
	"曖昧な表現や意見の相違は許容されます。",
	"評価理由は日本語で記述してください。"
	],
	evaluation_params=[
		SingleTurnParams.INPUT,
		SingleTurnParams.ACTUAL_OUTPUT,
		SingleTurnParams.EXPECTED_OUTPUT,
	]
)

# 評価
test_case = LLMTestCase(
	input=input,
	actual_output=response['message']['content'],
	expected_output="Functional Suitability, Performance Efficiency, Compatibility, Interaction Capability, Reliability, Security, Maintainability, Flexibility, Safety"
)

correctness_metric_ja.measure(test_case)
print("score:", correctness_metric_ja.score)
print("reason:", correctness_metric_ja.reason)

 ollama.chatで、評価対象に対し、課題を提示し回答を取得しています。
 そして評価対象の正確性についてG-Evalで評価しています。このうちevaluation_stepsが正確性をスコア評価するための評価指針になります。このコードでは前述の「生成AIアプリケーション評価入門」のサンプルをそのまま参考にして使用しています。

評価結果

 前述の評価コードの実行結果は以下に様になります:

score: 0.13775406687981456
reason: 期待される主特性は Functional Suitability、Performance Efficiency、Compatibility、Interaction Capability、Reliability、Security、Maintainability、Flexibility、Safety の列挙だが、実際の出力は Reliability、Security、Maintainability 以外に Durability、Customizability、Scalability、Accessibility、Environmental impact、Social responsibility など期待にない項目を多数含み、Compatibility・Interaction Capability・Flexibility・Safety・Functional Suitability が欠落しています。Performance も Performance Efficiency と厳密には一致せず、重要情報の省略と不正確な追加が大きいため低評価です。

 正確性は、事前に提示した評価指針に基づいて、0~1でスコア付けして提示しています。また、reasonとしてその理由を提示し、正確性の評価が妥当か確認できるようにしています。
 表示されている結果の通り、Judge側のLLMが、テスト対象の情報の古さや誤りを見つけ出し、減点していることが読み取れます。

副作用の局所化

 副作用の局所化はソフトウェアの設計アプローチです。対象のコンポーネントの副作用の発生可能性の軽減と、副作用の影響範囲の局所化を行うアプローチを指します。副作用の局所化は疎結合設計を支え、バグが少なく保守しやすいコードを生むために普遍的に重要な設計アプローチと言えます。

副作用とは

 ソフトウェアの設計やプログラミングにおける副作用は、意図した直接の出力とは別におこる作用を指します。例えば特定の値を返すことを目的とした関数を対象とした場合、値を返す以外に、内部でグローバルな状態・静的な状態を更新していれば、その状態更新が副作用になります。

 副作用を起こすものに以下があります。

  • グローバルな変数の更新
  • 静的な変数の更新
  • 共有するリソースやデータの更新
  • I/Oの実行
  • バッファオバーフローといった異常状態の発生
  • 上記を発生させる関数の呼び出し

 副作用は状態更新以外のものもあります。意図せず他の処理のタイミングや時間、順序を不適切に変えてしまう作用(例えばRTOSで動くソフトウェアにおいて、プロセッサリソースを占有して、他タスクの処理シーケンスを乱してしまうなど)も副作用です。ただし、副作用の局所化で語られる参照透過性や不変性などのコンテキストの中では、もっぱら副作用は状態更新に絞られます。

副作用の局所化

 副作用の局所化とは、副作用が発生する領域をなるべく小さな領域に閉じ込めること、副作用の発生可能性を軽減することを推進する設計アプローチです。
 状態更新の副作用に対しては、以下のような設計アプローチが、副作用の局所化に該当します。

  • 変数やリソースなどの状態のスコープを小さくする。グローバル変数を避ける
  • 静的な状態を少なくする
  • 横断的に共有される状態、静的な状態は、操作処理や、ガードといった防御的設計をまとめたオブジェクトとしてカプセル化する。状態更新についての防御的設計を複数に散在させない
  • 妥当な範囲で、参照透過性や不変性を確保する。例えば純粋関数(入力だけで出力を決め、外部に他の影響を発生させない関数)や、不変オブジェクト(初期化以外で状態を更新しない)として処理を実装する
  • バッファオーバーフローといった異常状態については、開発言語機能、型システム、コーディングルール、静的解析といった多重の手段で解消を目指す

 この副作用の局所化は保守性向上を中心に、さまざまな恩恵を提供します。主要なものを以下に示します。

  • デバッグが容易になる。バグ原因の発生可能性の範囲を狭く絞り込める
  • テストが容易になる。テストの入力・出力が明確化され、小さく絞り込まれる。ユニットテストなどで対象を切り出すのも容易になる
  • 再利用性を高める。再利用の際の前提条件や注意事項が小さくなる

不変オブジェクト

 副作用の局所化の実装手段として不変オブジェクトがあります。不変オブジェクトは、オブジェクト生成時の初期化を除いて、オブジェクトの状態を変更できないオブジェクトを指します。不変オブジェクトとして実装すれば副作用をなくせるわけではありませんが、副作用の発生可能性を下げ、副作用の範囲を削減する手段として有効です。

 例えばC++で以下のクラスUserがあるとします。

class User {
public:
    std::string name;
    int age;

    User(const std::string& name_str, int age_val) : name(name_str), age(age_val) {}
    
    ...さまざまなメソッド...
};

 このUserクラスはnameとageのパラメータを持ちます。この実装ではインスタンス化した後もnameとageを更新できるため、これは可変オブジェクトになります。外部から自由に更新できるため、Userのインスタンスは副作用の影響を受けやすいと言えます。

 このUserクラスを不変オブジェクトとして実装する場合、次のようになります

class User {
private:
    const std::string name_;
    const int age_;

public:
    User(const std::string& name, int age)
        : name_(name), age_(age) {}

    std::string getName() const { return name_; }
    int getAge() const { return age_; }

    ...さまざまなメソッド...
};

 すべてのパラメータについてconstを付与し、不変性を担保しています。Getterを定義する場合は、const宣言で内部のパラメータを更新しないことを担保します。

ドメインプリミティブな設計

 副作用の局所化と組み合わせるのが効果的な設計アプローチに、ドメインプリミティブという設計指針があります。これはドメイン駆動設計での用語で、プリミティブ型(開発言語の標準の基本型。intやstringなど)を使用せず、ドメインのコンテキストに合わせた独自型を使用すべきというものです。ドメインプリミティブの設計では、型にバリデーションを組み込み、オブジェクトが常に正しい状態の実現も目指します。ドメインプリミティブを遵守することで、不正な状態更新を抑止し、有害な副作用の影響を抑えることができます。

 例えば前述のUserクラスをドメインプリミティブの設計に基づいて改善した例を以下に示します。

class User {
private:
    const std::string name_;
    const int age_;

    static std::string validateName(const std::string& name) {
        if (name.length() < 1 || name.length() > 20) {
            throw std::invalid_argument("name must be between 1 and 20 characters");
        }
        return name;
    }

    static int validateAge(int age) {
        if (age < 0 || age > 200) {
            throw std::invalid_argument("Age must be between 0 and 200");
        }
        return age;
    }

public:
    User(const std::string& name, int age)
        : name_(validateName(name)), age_(validateAge(age)) {}

    std::string getName() const { 
        return name_; }
    int getAge() const { return age_; }

    ...さまざまなメソッド...
};

 ドメインプリミティブの設計では、ユーザの名前や年齢をstring型やint型そのままで定義するのではなく、上記のUserクラスで定義するように統一します。
 このUserクラスでは、値の初期化時に入力バリデーションを行い、不正な状態が指定された場合は例外で弾くように実装しています。こうした事前条件の評価・防御的処理を組み込むことで、常に正しい状態のオブジェクトしか存在しないように実装できます。これにより、有害な影響を発生させる副作用を抑止できます。

Androidをとりまくテストスイート(xTS:CTS、VTS、STS、GTS)の概要

 Android開発に関しては、仕様に準拠しているか、互換性を満たしているか、セキュリティといった特定の品質を実現しているか確認するためのテストスイートが複数提示されています。これらはAndroid xTSとも呼称されます。今回はその主要なxTSをまとめます。

CTS(Compatibility Test Suite)

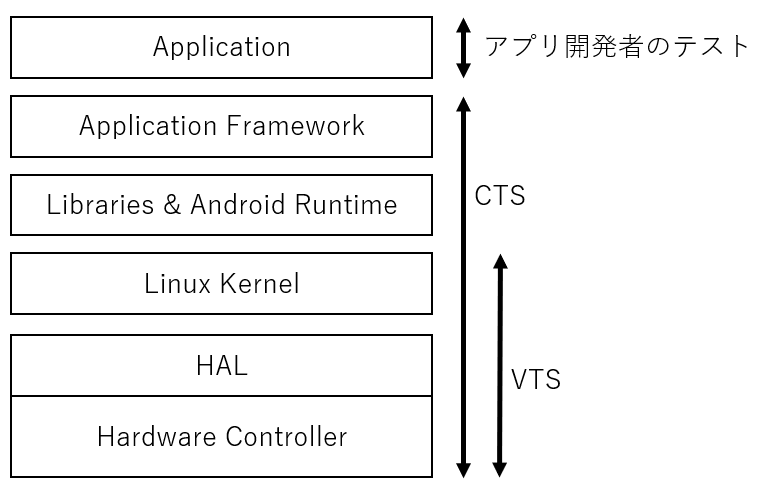
 CTSは、対象のデバイスのAndroidのAPIが標準仕様を実現しており、デバイスが、サードパーティのAndroidアプリーケーションを動作させられるか確認するテストスイートです。

 CTSでは、端末メーカーのカスタマイズで標準のAndroid APIが壊れていないか、妥当な性能を確保しているかといった確認を行います。CTS合格の保証によりアプリケーション開発者に対するWORA(Write once, run anywhere:一回コードを書けばどのAndroid端末でも動作する)の実現を支えます。
 CTSはホスト環境から端末をリモートで操作して実行します。

 テストの概要やソースコードは公開されています。
互換性テストスイート(CTS)の概要  |  Android Open Source Project

 CTSのテストベースは以下のCDD(Compatibility Definition Document)になります。
Android 互換性定義ドキュメント  |  Android Open Source Project

 注意点として、テストコードを確認すれば分かりますが、CDDに対してCTSは基本的な確認しか実施していません。CDDの実現保証には、手動テストやレビュー、網羅性を高めたテストも必要です。

VTS(Vendor Test Suite)

 VTSは、Androidのハードウェアベンダーインターフェースが要件を実現しているか確認するテストスイートです。

 VTSは複数のテストで構成されます。構成要素の一つに、Google TestでHALを切り出してテストするコンポーネントテストがあります。またLinux Kernelを接続した統合テストやAPIテスト、LTP(Linux Test Project)準拠のテストによる、OSとハードウェアの疎通確認も含まれます。そこではGSI(Generic System Image)を使って汎用的な確認を実施します。
 VTSでハードウェアベンダーインターフェースの実現性保証を行うことで、ハードウェアバリエーションが増加・爆発した状態でも、円滑にAndroidフレームワークをアップデートしたり、Android APIの標準性を担保したりできるようにする状態を実現します。

 VTSのテストベースは、VSR(Vendor Software Requirements)と呼ばれるベンダーに対する一連の要件とHALの設定になります。VSRは前述のCDD中のハードウェアベンダーに対する要件や、ベンダーAPI仕様で構成されます。

 VTSとCTSの関係を以下に示します。


GTS(Google Mobile Services Test Suite)

 Google提供のサービス(Play Services等)やアプリ(Playストア等)の動作確認を行うテストスイートです。Google自身のサービスの品質確認を行うほか、端末メーカーがGoogleサービスを組み込んで出荷する際に正しく組み込まれているかの確認で使われます。一般公開されていません。

STS(Security Test Suite)

 Androidの脆弱性対策、セキュリティ確保が適切か確認するテストスイートです。テストを実行する仕組みは公開されており、関係開発者が実行可能になっています。ただテスト内容の詳細は、脆弱性情報や攻撃手段を含むため一般公開されていません。

GitHub Copilotでユニットテストを楽に構築・運用する

 十分かつ有効なユニットテストが配備されるとさまざまな恩恵が提供されます。リグレッションテストとして使用可能です。またリファクタリングや追加変更もより安全に進められるようになります。
 ただユニットテストは数が多くプロダクトコードと結合しているため、その構築・保守には手間がかかりがちです。特にプロダクトコードのテスト容易性が低いとその手間が大きくなり、ユニットテストの費用対効果が悪化します。
 こうしたユニットテストを取り巻く煩雑な手間についてですが、生成AIのサポートでかなり手間を削減できます。今回は生成AIサービスのGitHub Copilotを例に、ユニットテストの構築・運用を楽にする簡単なテクニックをまとめます。

ユニットテストを生成する

 GitHub Copilotを使うとテストコードのスケルトンやたたき台を容易に生成できます。例えば次のようなコードがあるとします。

target.cpp

#include <utility>
#include <vector>
#include "target.h"

int partition(std::vector<int>& arr, const int low, const int high) {
    const int pivot = arr[high];
    int i = low - 1;
    for (int j = low; j < high; j++) {
        if (arr[j] < pivot) {
            i++;
            std::swap(arr[i], arr[j]);
        }
    }
    std::swap(arr[i + 1], arr[high]);
    return i + 1;
}

void quickSort(std::vector<int>& arr, const int low, const int high) {
    if (low < high) {
        const int pi = partition(arr, low, high);
        quickSort(arr, low, pi - 1);
        quickSort(arr, pi + 1, high);
    }
}

target.h

#pragma once

#include <vector>

void quickSort(std::vector<int>& arr, const int low, const int high); 

 こうしたファイルに対しては、GitHub Copilotのチャットビューで「test.cppに対するユニットテストを作成してください。別ファイルで作ってください」と指示を打ち込みます(今回は簡単な例なのでこれで済みますが、複雑なプロジェクトに対しては追加のプロンプトが求められます)。
 するとGitHub CopilotはGoogle TestやCMakeなど必要なツールのインストールを許可を取りながら進めます。そして以下のユニットテストファイルを生成します。

test_target.h

#include <gtest/gtest.h>
#include <vector>
#include "target.h"

TEST(QuickSortTest, SortsAlreadySortedVector) {
    std::vector<int> arr = {1, 2, 3, 4, 5};
    quickSort(arr, 0, static_cast<int>(arr.size()) - 1);
    EXPECT_EQ(arr, std::vector<int>({1, 2, 3, 4, 5}));
}

TEST(QuickSortTest, SortsReverseSortedVector) {
    std::vector<int> arr = {5, 4, 3, 2, 1};
    quickSort(arr, 0, static_cast<int>(arr.size()) - 1);
    EXPECT_EQ(arr, std::vector<int>({1, 2, 3, 4, 5}));
}

TEST(QuickSortTest, SortsRandomOrderVector) {
    std::vector<int> arr = {3, 1, 4, 1, 5};
    quickSort(arr, 0, static_cast<int>(arr.size()) - 1);
    EXPECT_EQ(arr, std::vector<int>({1, 1, 3, 4, 5}));
}

TEST(QuickSortTest, SortsSingleElementVector) {
    std::vector<int> arr = {42};
    quickSort(arr, 0, static_cast<int>(arr.size()) - 1);
    EXPECT_EQ(arr, std::vector<int>({42}));
}

TEST(QuickSortTest, EmptyVectorDoesNothing) {
    std::vector<int> arr;
    EXPECT_NO_THROW(quickSort(arr, 0, static_cast<int>(arr.size()) - 1));
    EXPECT_TRUE(arr.empty());
}

 またGitHub Copilotは同時にCMakeLists.txtといったビルド・実行のための設定ファイルも自動生成・更新し、生成したユニットテストをビルド・実行可能にします。
 実行結果です:

[       OK ] QuickSortTest.SortsRandomOrderVector (0 ms)
[ RUN      ] QuickSortTest.SortsSingleElementVector
[       OK ] QuickSortTest.SortsSingleElementVector (0 ms)
[ RUN      ] QuickSortTest.EmptyVectorDoesNothing
[       OK ] QuickSortTest.EmptyVectorDoesNothing (0 ms)
[----------] 5 tests from QuickSortTest (0 ms total)

[----------] Global test environment tear-down
[==========] 5 tests from 1 test suite ran. (0 ms total)
[  PASSED  ] 5 tests.

 注意点として、生成されたユニットテストのテストケースは通常そのまま信用できるのではなく、修正や補強が必要です。ただたたき台を自動生成させれば、ゼロからテストコードを手打ちするよりはるかに楽にユニットテストを確保できます。

テストコードの実装を補完させる

 GitHub Copilotでは、テストコードのプログラミングの中で細部のスニペット生成や実装候補の提案も高度に実施してくれます。
 例えば前項で生成したユニットテストのファイルで「//巨大な要素数で動作することを確認 」とコメントを入力してコード提案を実行させると、コメントに沿ったテストメソッドが提案されます。

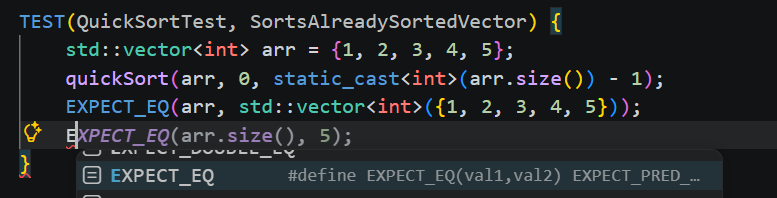
 また高度なコード補完・コードスニペット生成手段としても有効です。テストメソッド中に「E」を入力すると、EXPECT_EQのアサーションメソッドの記述が提案されます。

プロダクトコードの変更に追従させる

 GithubCopilotではプロダクトコードの変更対応も高度に自動化できます。
 例えばプロダクトコードに次の関数を追加したとします。

target.cpp

void BubbleSort(std::vector<int>& arr) {
    const int n = static_cast<int>(arr.size());
    for (int i = 0; i < n - 1; i++) {
        for (int j = 0; j < n - i - 1; j++) {
            if (arr[j] > arr[j + 1]) {
                std::swap(arr[j], arr[j + 1]);
            }
        }
    }
}

 こうしたプロダクトコード変更に対しては、チャットビューで「target.cppを網羅するユニットテストを作成してください。既存のユニットテストtest_target.cppを修正して対応してください」といったプロンプトを入力すると、プロダクトコードの変更に追従したテストコード修正が実施されます。今回の例では、追加関数に対する追加テストコードが作成されます。

 また例えば追加した「BubbleSort」を「bubbleSort」に置換した場合に対するセルフヒーリングも可能です。例えば「target.cppの変更に対応して、ユニットテストを修正してください」とプロンプトを実行すると、置換に対応したヘッダファイルとテストコード修正が実施され、実行可能確認が行われます。

テスト駆動開発のサポートを行う

 テスト駆動開発は、生成AIとかなり親和性が高いプログラミングスタイルだと前々からよく言われています。それは事実なのですが、注意点として生成AIを前提とした場合、テスト駆動開発の進め方やサイクルサイズが変化します。
 通常テスト駆動開発は次のステップで進めます。

1. 仕様をテストリストとして明文化する
2. テストリストの1項目について、テストを書いて失敗させる
3. テストの失敗を成功に変えるようにプロダクトコードを変更する

※このうち2、3をテストリスト全てに対応するまで繰り返す
※また一定のプロダクトコードがたまったら、適宜リファクタリングを実施してプロダクトコードを綺麗にする

 これを生成AI活用を前提とすると、次のような流れになります。

1. 仕様をテストリストとして明文化する
2. テストリストについて、プロダクトコードとテストコードを一緒に生成する
3. テストコードのテスト設計・テスト実装を適切なものに修正する
4. テスト成功状態を維持しながら、プロダクトコードを適切なものに修正する

 通常のテスト駆動開発では、テスト失敗→テスト成功のテストファーストのサイクルは数十秒から数分の短期サイクルです。しかし生成AIを使った場合、一気にすべてを生成できるため、サイクルが大きくなります。さらにテストを失敗するステップの恩恵が小さくなり、多くの場合スキップすることになります。